GAN vs diffusion : quelle différence pour vos visuels IA
GAN vs diffusion : deux façons de fabriquer une image. Fonctionnement, qualité, contrôle, vitesse et verdict selon votre cas d'usage réel.

Comment un GAN fabrique une image
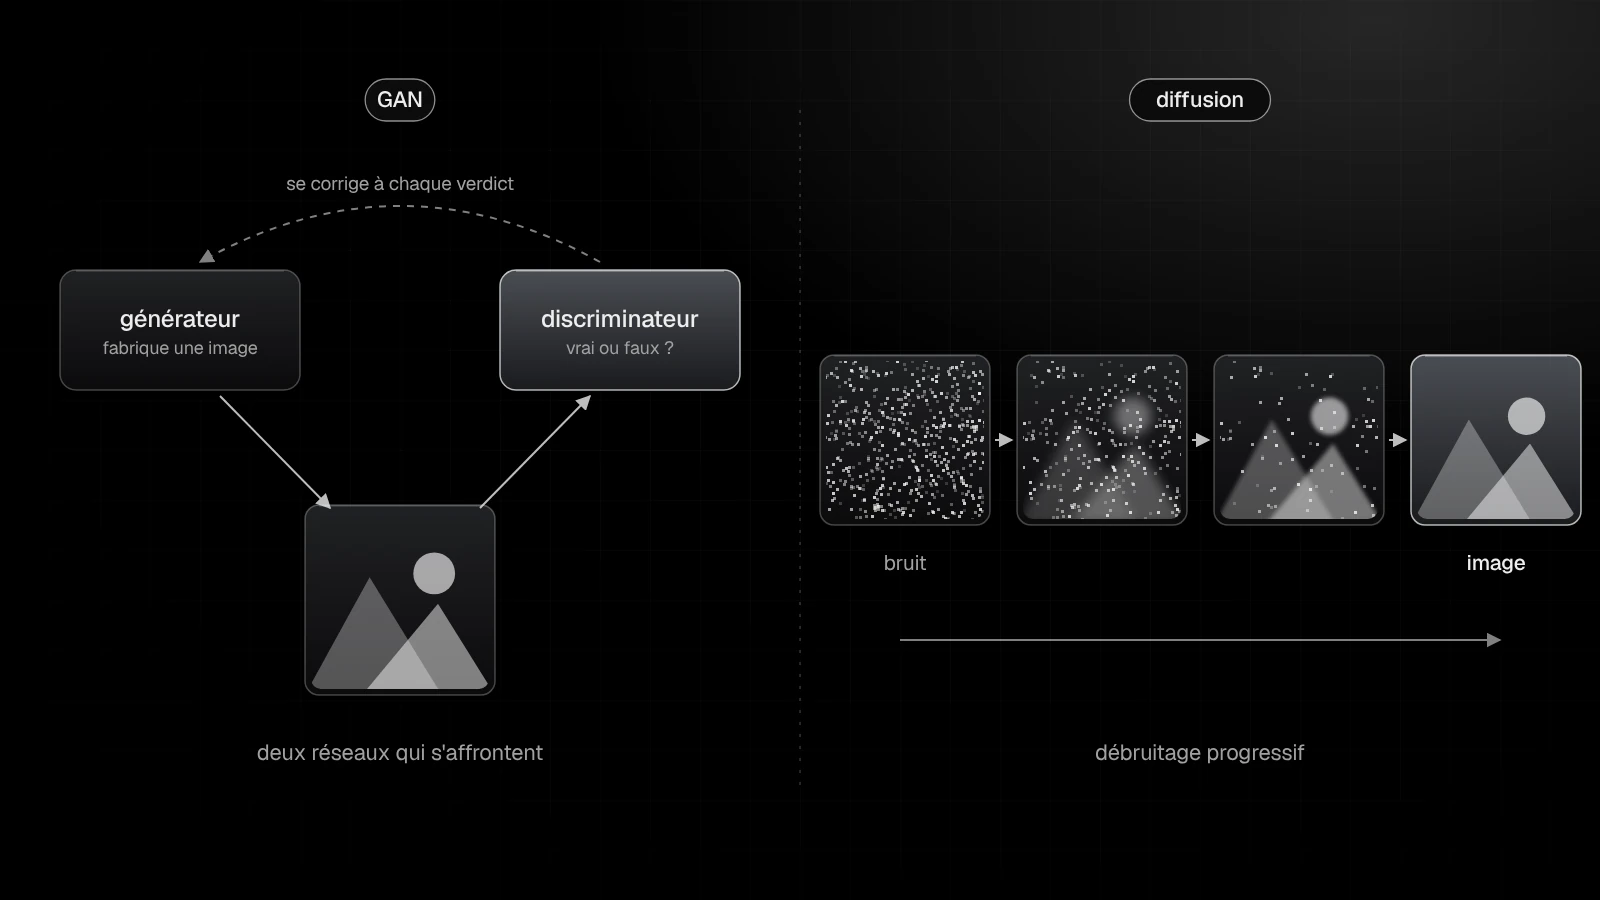
Un GAN met deux réseaux de neurones en concurrence. Le premier, le générateur, propose une image. Le second, le discriminateur, essaie de deviner si elle vient du jeu de données réel ou de son adversaire. Chacun progresse en faisant échouer l'autre, et au bout de l'entraînement le générateur produit des images que son juge ne distingue plus des vraies.
Le point décisif tient dans le nombre d'opérations. Le générateur part d'un vecteur aléatoire et sort l'image en une seule passe. Pas d'étapes successives, pas d'allers-retours : le calcul est court, ce qui rend cette approche imbattable quand il faut un résultat instantané. Cette mécanique, posée au milieu des années 2010, a dominé la première vague de la génération d'images par IA.
Les limites qu'on rencontre vite

- L'entraînement est instable : le duel peut s'emballer ou se figer, et il faut beaucoup d'essais pour obtenir un modèle utilisable.
- Le modèle a tendance à se replier sur quelques solutions qui marchent, donc à produire des images qui se ressemblent toutes.
- Brancher une longue description textuelle dessus reste compliqué : un GAN excelle sur un domaine étroit, pas sur « tout ce que vous pouvez écrire ».
- Les retouches partielles ne sont pas naturelles pour lui, puisqu'il n'y a pas d'étape intermédiaire où intervenir.
Comment un modèle de diffusion s'y prend
La diffusion inverse une destruction. Pendant l'entraînement, on ajoute progressivement du bruit à des images réelles jusqu'à ce qu'il ne reste rien de lisible, et le modèle apprend à prédire ce bruit. À la génération, on repart d'un bruit pur et on applique cet apprentissage dans l'autre sens : le modèle retire un peu de bruit, regarde, recommence. L'image apparaît par couches, du volume général vers les détails fins. Nous avons détaillé ce cycle dans notre article sur le fonctionnement d'un modèle de diffusion.
Chaque étape est une occasion de reprendre la main. C'est là que tout se joue : on peut injecter un texte à chaque pas, forcer une structure, geler une partie de l'image, repartir d'une photo existante. Le texte est encodé puis réinjecté dans le débruitage, et un réglage de guidage dose l'obéissance au prompt. Plus d'étapes donne généralement plus de détail, jusqu'à un palier où le gain devient invisible et où vous payez du calcul pour rien.
Qualité de rendu : qui produit les meilleures images
Sur un domaine fermé et bien cadré, un GAN bien entraîné donne des images nettes, sans le léger lissage qu'on reproche parfois à d'autres familles. Des visages en gros plan, un seul type d'objet, un style unique : il tient la comparaison. Nous le disons franchement, sur ces tâches précises il reste redoutable et certains agrandisseurs d'image s'appuient encore dessus.
Dès que le sujet s'élargit, l'écart se creuse. Un modèle de diffusion couvre une variété de scènes, de matières et de styles qu'un GAN n'atteint pas, parce qu'il n'a pas besoin de tromper un juge unique pour chaque image. Les scènes composées, les reflets, les textures de tissu ou de verre, la cohérence d'un décor entier : c'est son terrain. Si votre objectif est un visuel photoréaliste sur un sujet libre, la question ne se pose plus vraiment.
Contrôle et prise en main : la vraie fracture
C'est le critère qui décide à votre place. Avec la diffusion, vous disposez d'un prompt, d'un prompt négatif, d'une graine pour reproduire un résultat, d'un dosage du guidage, et de tout un outillage greffé par-dessus. Un LoRA ajoute un style ou un produit, ControlNet impose une pose ou une perspective, l'inpainting corrige une zone sans toucher au reste. Rien de tout cela n'existe de façon comparable côté GAN, où l'on agit sur un vecteur latent dont les axes sont rarement lisibles.
En pratique, vous ne choisissez pas une architecture : vous choisissez un modèle dans une interface. Dans notre générateur d'images, les modèles proposés sont des modèles de diffusion ou des hybrides diffusion-transformeur, et l'essentiel de votre progression viendra de votre façon d'écrire le prompt, pas du sigle derrière le bouton.
Et le VAE, et les transformeurs

Trois familles reviennent dans les discussions, et elles jouent des rôles différents. L'auto-encodeur variationnel, le VAE, compresse une image dans un espace réduit puis la reconstruit. Seul, il produit des rendus un peu mous. Mais c'est précisément ce qu'on lui demande dans la diffusion latente : compresser pour que le débruitage coûte moins cher, puis décoder. Autrement dit, le VAE n'est pas un concurrent, c'est une pièce du moteur.
Les approches dites autorégressives, proches des transformeurs de texte, prédisent l'image morceau par morceau comme une suite de jetons. Elles brillent sur le respect des instructions et le texte dans l'image. Plusieurs modèles récents mélangent d'ailleurs les logiques, avec un transformeur comme épine dorsale d'un processus de diffusion. Si vous voulez situer tout cela dans l'ensemble du paysage, notre page sur l'IA générative remet les familles à leur place.
Le vocabulaire anglais à connaître
- « generative adversarial networks (GANs) » : réseaux antagonistes génératifs, le nom complet derrière le sigle.
- « diffusion models » : les modèles de diffusion, ceux qui partent du bruit.
- « what are generative models » : la formulation des cours en ligne, pratique pour trouver des bases propres.
- « sample » : un échantillon, donc une image produite ; le « sampler » est la méthode qui pilote les étapes.
- « classifier free guidance » : le dosage de l'obéissance au texte, affiché comme guidance ou CFG dans les interfaces.
- « conditioning: text and user image » : les entrées fournies au modèle, un texte et une image de référence.
Les tournures se répètent d'un dépôt à l'autre. Vous lirez « GANs for image synthesis », un correctif annoncé « to improve the sample quality », ou une note qui prévient qu'un résultat « may vary » d'une exécution à l'autre. Sur les forums, c'est plus direct : « which one is better for our tools », « can you generate highly detailed images with this », « here are the last results from the core of the model ». Un prompt court y est parfois décrit comme « a hint to help the classifier », reste des premières méthodes guidées, et on parle de « generation times » pour le temps de calcul. Rien de mystérieux, ce sont les mêmes idées qu'en français.
Vitesse, coût et usage commercial
Un GAN génère en une passe, donc il reste le choix des contextes où la latence compte plus que la variété : un effet temps réel, un filtre embarqué, un agrandissement rapide. La diffusion demande plusieurs passes, mais les méthodes de distillation ont beaucoup réduit le nombre d'étapes nécessaires, et le coût ressenti côté utilisateur a fondu. Chez nous, une image coûte environ 2 crédits et une vidéo courte de 11 à 16 crédits selon le module, ce qui place le vrai sujet ailleurs : le nombre d'essais avant la bonne image.
Côté droits, l'architecture ne change rien. Ce qui compte, c'est la licence du modèle et les conditions de la plateforme que vous utilisez, pas la façon dont les pixels sont calculés. Les modèles ouverts et les modèles fermés ne s'exploitent pas aux mêmes conditions, sujet que nous traitons dans notre comparaison open source et propriétaire, et les règles d'usage commercial d'une image IA méritent une lecture avant toute campagne.
Lequel choisir selon votre cas

Si vous créez des visuels sans entraîner de modèle, le débat est tranché : vous travaillerez en diffusion, parce que c'est là que vivent le contrôle, les styles et les outils d'édition. Si vous construisez un système sur mesure, la réponse dépend de votre contrainte principale.
- E-commerçant, créateur ou marketeur : diffusion, sans hésiter, pour la variété et pour pouvoir reprendre une image avec de la retouche IA.
- Besoin d'un rendu instantané sur un domaine unique, par exemple un effet caméra en direct : un GAN garde un vrai avantage de latence.
- Agrandissement et restauration : les deux coexistent, et beaucoup d'outils d'upscaling s'appuient encore sur une brique antagoniste.
- Jeu de données minuscule et très homogène : un GAN peut converger là où la diffusion demanderait plus de matière.
- Recherche ou projet pédagogique : entraîner un petit GAN reste la façon la plus lisible de comprendre ce qu'est un générateur.
Questions fréquentes
Non, c'est un modèle de diffusion latente, comme son nom l'indique. Il débruite dans un espace compressé par un auto-encodeur, ce qui explique sa légèreté relative. Vous pouvez d'ailleurs l'utiliser sans rien installer via une plateforme en ligne.
Pas abandonnés, mais déplacés. Ils ont perdu la bataille de la génération ouverte guidée par le texte, et ils tiennent encore des rôles précis : super-résolution, restauration, effets rapides, décodeurs internes. Les voir comme une brique spécialisée plutôt que comme une alternative généraliste est plus juste.
Elle l'est par construction, puisqu'elle enchaîne plusieurs passes au lieu d'une seule. L'écart s'est pourtant beaucoup réduit avec les modèles distillés, qui travaillent en très peu d'étapes. Sur une interface en ligne, la différence de ressenti est aujourd'hui marginale pour une image fixe.
Non, mais ça aide à diagnostiquer. Savoir qu'une image se construit par étapes rend logiques le nombre de steps, le guidage et la force appliquée à une image de départ. Si vous générez surtout des visuels produit, notre packshot produit applique déjà ces réglages pour vous.




