Comment fonctionne un modèle de diffusion : guide clair
Du bruit à l’image : comprenez le processus de diffusion, le rôle des données, et réglez étapes, guidage et seed pour de meilleures générations.

Que se passe-t-il vraiment quand vous lancez une génération ?

Vous écrivez un prompt, vous attendez quelques secondes, l’image arrive. Entre les deux, le modèle ne va pas chercher une photo dans une banque d’images : il fabrique de nouvelles valeurs de pixels, une par une. Son point de départ est un champ de bruit, c’est-à-dire une grille de valeurs tirées au hasard, sans aucune structure lisible. Tout le travail consiste à retirer ce bruit dans la bonne direction, celle que décrit votre texte. Si le fonctionnement général d’un générateur d’images IA vous est encore flou, c’est le bon moment pour poser cette base.
D’où vient le bruit de départ
Ce bruit n’est pas aléatoire au sens courant du terme. Il est tiré d’une distribution gaussienne, la courbe en cloche, avec une moyenne de zéro et une variance connue. Cette régularité est ce qui rend la suite possible : le réseau a été entraîné à reconnaître précisément ce type de désordre et rien d’autre. Changez le nombre qui sert à tirer cette grille initiale, et vous obtenez une image complètement différente avec le même prompt.
Le débruitage se fait par petites corrections
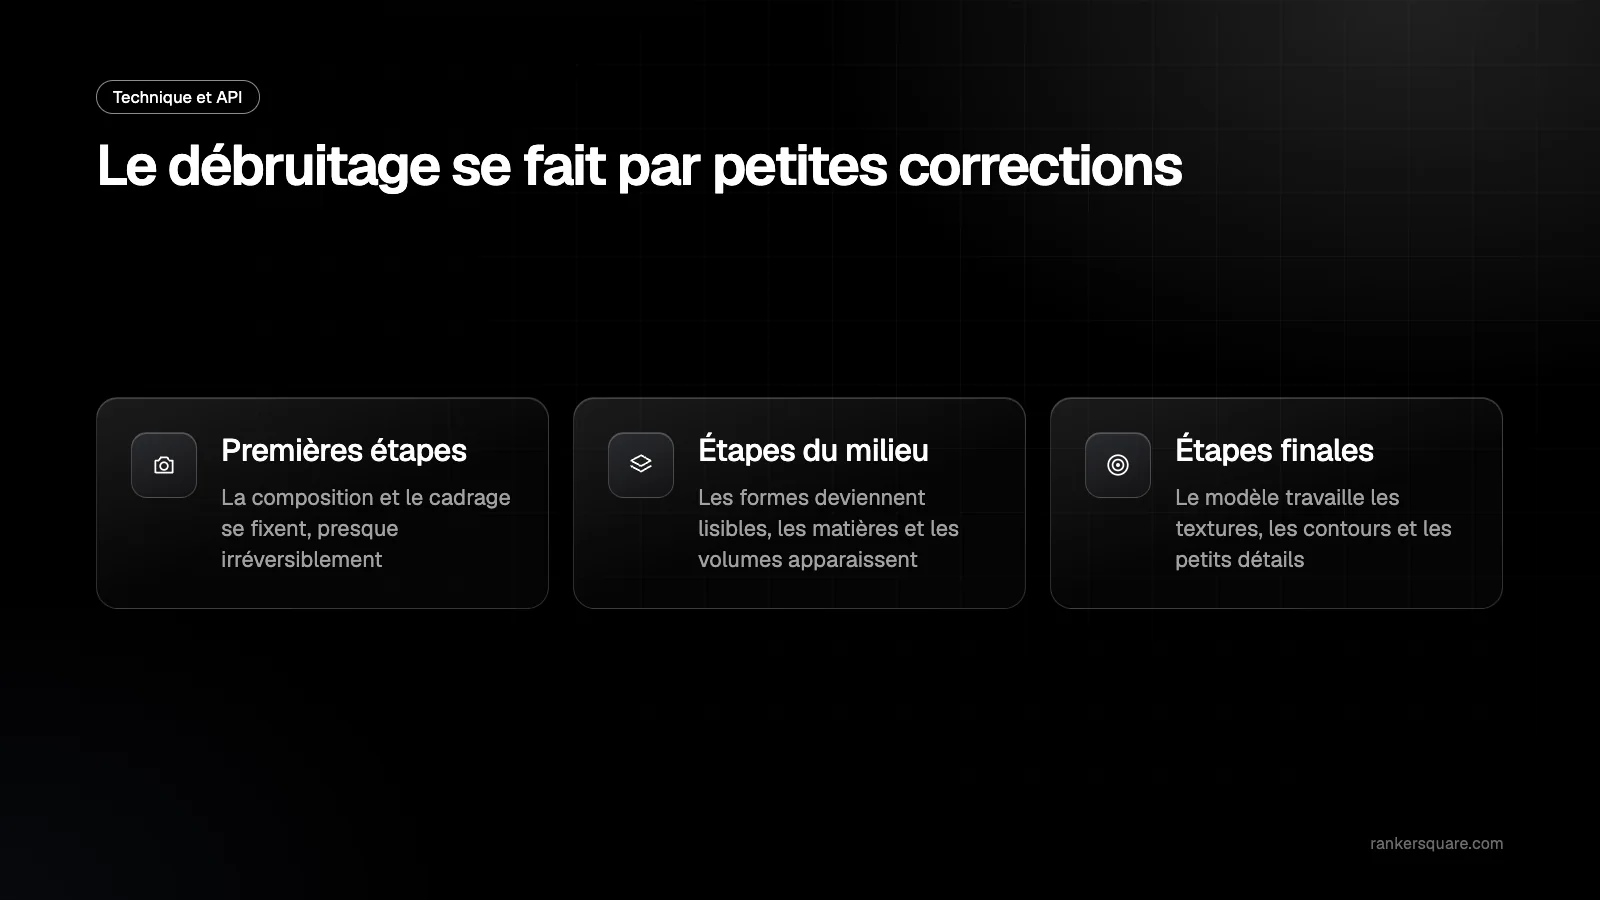
Le modèle ne passe pas du bruit à l’image en un seul calcul. Il procède par passages successifs : à chaque fois, il estime quelle part de ce qu’il voit est du bruit, en retire une partie, puis recommence sur le résultat. Une génération en vingt-cinq étapes, ce sont vingt-cinq estimations enchaînées. Nous voyons cette progression sur les aperçus intermédiaires : d’abord des masses de couleur, puis une silhouette, puis les détails.
- Premières étapes : la composition et le cadrage se fixent, presque irréversiblement.
- Étapes du milieu : les formes deviennent lisibles, les matières et les volumes apparaissent.
- Étapes finales : le modèle travaille les textures, les contours et les petits détails.
- Au-delà d’un certain point, les gains sont minimes et vous payez du temps de calcul pour rien.
Pourquoi le terme « diffusion » vient de la physique
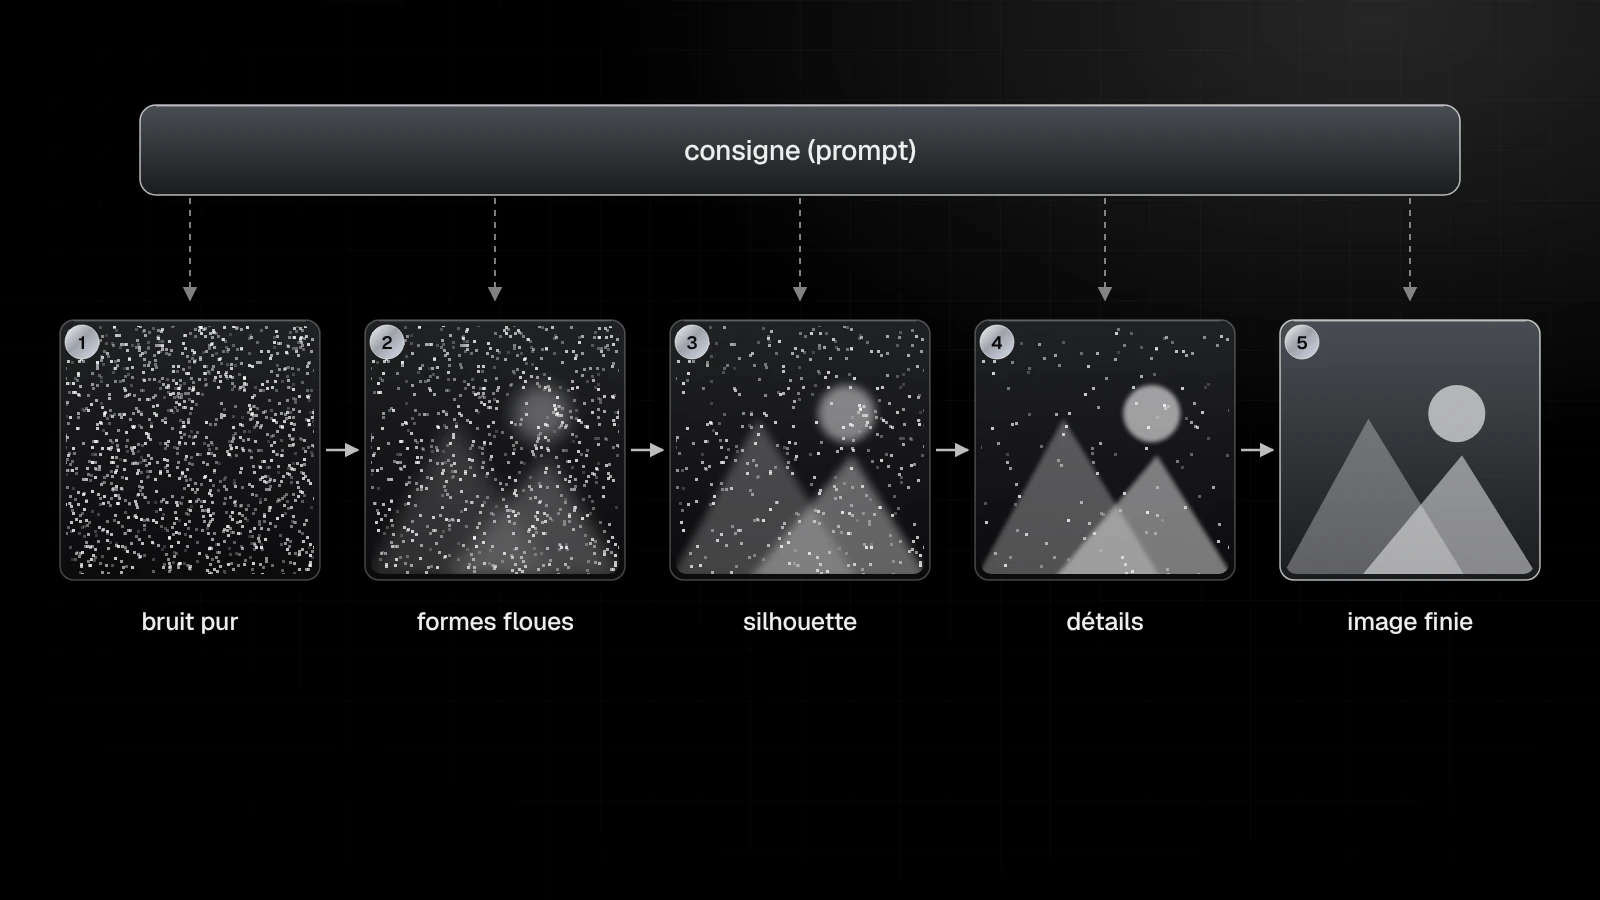
Le terme est emprunté à la thermodynamique. Une goutte d’encre dans un verre d’eau se répand jusqu’à ce que la couleur devienne uniforme : l’information de départ, la position de la goutte, se perd définitivement. Ce phénomène s’appelle la diffusion et se décrit avec des équations de dynamiques aléatoires. Un diffusion model applique ce concept à des images, avec une idée supplémentaire : apprendre à remonter le film.
Le processus direct détruit l’information
Pendant l’entraînement, on prend une image réelle et on lui ajoute du bruit en plusieurs centaines de petits incréments. Au début, elle reste parfaitement reconnaissable. À la fin, il ne reste qu’un désordre statistique où aucun objet n’est identifiable. Ce processus de diffusion est entièrement calculé et non appris : il suit une formule fixe, avec des coefficients choisis à l’avance pour chaque étape.
Le processus inverse, lui, doit s’apprendre
C’est ici qu’intervient le réseau de neurones. On lui montre d’énormes quantités de paires « image bruitée, bruit qui a été ajouté » et on lui demande de deviner le second à partir du premier. S’il y parvient, il sait annuler une étape de bruit. Enchaînez ces annulations et vous obtenez la diffusion inverse, le processus inverse du précédent, qui part du désordre pour aboutir à une image cohérente.
Quel rôle jouent les données d’entraînement et la distribution apprise ?
Un modèle de diffusion n’apprend pas des images une par une, il apprend une distribution : la façon dont les valeurs de pixels se répartissent et se répondent dans l’ensemble qu’on lui a montré. Générer revient alors à tirer un nouvel échantillon dans cette distribution. D’où une règle que nous répétons à nos utilisateurs : un modèle ne sait bien produire que ce qui était bien représenté dans son jeu de données.
Un jeu de données définit ce qui est possible
Les photos de produits sur fond blanc, les portraits en lumière de studio, les plats vus de dessus : ces registres sont massivement présents sur le web, donc dans les corpus d’entraînement. Les modèles les rendent avec une aisance remarquable. À l’inverse, les sujets peu photographiés, les objets techniques de niche ou les gestes rares restent fragiles. Le cas des mains ratées en IA s’explique en grande partie comme cela : trop de configurations différentes, pas assez d’exemples propres pour chacune.
Ce que la distribution ne contient pas
- Un produit sorti après la collecte des données : le modèle ne le connaît pas et l’approxime.
- Du texte long dans l’image, où les caractères sont traités comme des formes et non comme des mots.
- Des logos et des chartes propriétaires, qu’il reconstruit de mémoire, souvent de travers.
- Le visage d’une personne précise, sauf si ce visage est très documenté publiquement.
- Des combinaisons physiquement improbables, que la distribution initiale n’a jamais vues.
Quand une caractéristique manque, il reste l’adaptation. Entraîner un LoRA sur vos propres visuels ajoute un petit jeu de paramètres spécifiques au modèle de base, sans le réentraîner entièrement. C’est le moyen le plus économique d’apprendre à un diffusion model votre packaging, votre mannequin récurrent ou votre style maison. La capacité du modèle d’origine reste le plafond : l’adaptation orientera son attention, elle ne crée pas une compétence absente.
Les mathématiques du processus de diffusion, en termes simples
Vous n’avez pas besoin de manipuler des équations pour piloter l’outil. Mais deux ou trois idées rendent les réglages nettement moins mystérieux, et vous évitent de tourner des curseurs au hasard.
Une équation à deux termes
L’ajout de bruit s’écrit très simplement : l’image bruitée vaut l’image originale multipliée par un coefficient, plus du bruit multiplié par un second coefficient. Ces deux coefficients dépendent de l’étape, et la somme de leurs carrés reste constante tout du long. Au début, le premier terme domine et l’image survit. À la fin, le second l’emporte et il ne reste plus rien du signal d’origine.
La fonction apprise est une estimation du bruit
Le réseau ne prédit pas l’image finale. Il prédit le bruit, ce qui revient au même puisque l’équation ci-dessus permet de passer de l’un à l’autre. Cette estimation est la fonction centrale du modèle : on lui fournit une image bruitée, le numéro de l’étape et le texte encodé, elle renvoie son meilleur pari sur le bruit présent. Les milliards de paramètres du réseau ne servent qu’à affiner ce pari.
Pourquoi l’espace latent accélère tout
Débruiter directement des pixels en haute résolution coûte très cher en calcul. Les modèles actuels compriment donc l’image dans un espace latent : une représentation plus petite qui conserve la structure et jette le superflu. La diffusion se déroule dans cet espace, puis un décodeur remonte vers les pixels. Cette technologie explique la rapidité des générations, et aussi pourquoi certains détails fins se perdent, ce qu’un passage d’upscaling IA rattrape en partie.
Quels paramètres font varier le résultat ?
Trois réglages pèsent plus que tous les autres. Ils ne sont pas toujours exposés dans les interfaces grand public, mais ils sont à l’œuvre dans chaque génération, y compris quand l’outil les choisit pour vous.
Le nombre d’étapes
C’est le nombre de corrections appliquées entre le bruit et l’image. Trop peu, et l’image reste molle, avec des contours approximatifs et des textures sales. Beaucoup, et vous gagnez surtout de la patience : au-delà d’une trentaine d’étapes, l’écart devient difficile à voir sur un visuel standard. Nous travaillons le plus souvent dans une fourchette moyenne, et nous montons uniquement pour des plans très détaillés.
Le guidage du texte
Ce paramètre dose la fermeté avec laquelle le prompt oriente le débruitage. Bas, le modèle improvise et s’éloigne de votre demande. Haut, il obéit au mot près, mais les couleurs saturent, les contours durcissent et les visages prennent un aspect plastique. Le bon réglage est un compromis, et il dépend du modèle : une valeur idéale sur l’un donne des valeurs caricaturales sur l’autre.
Le seed
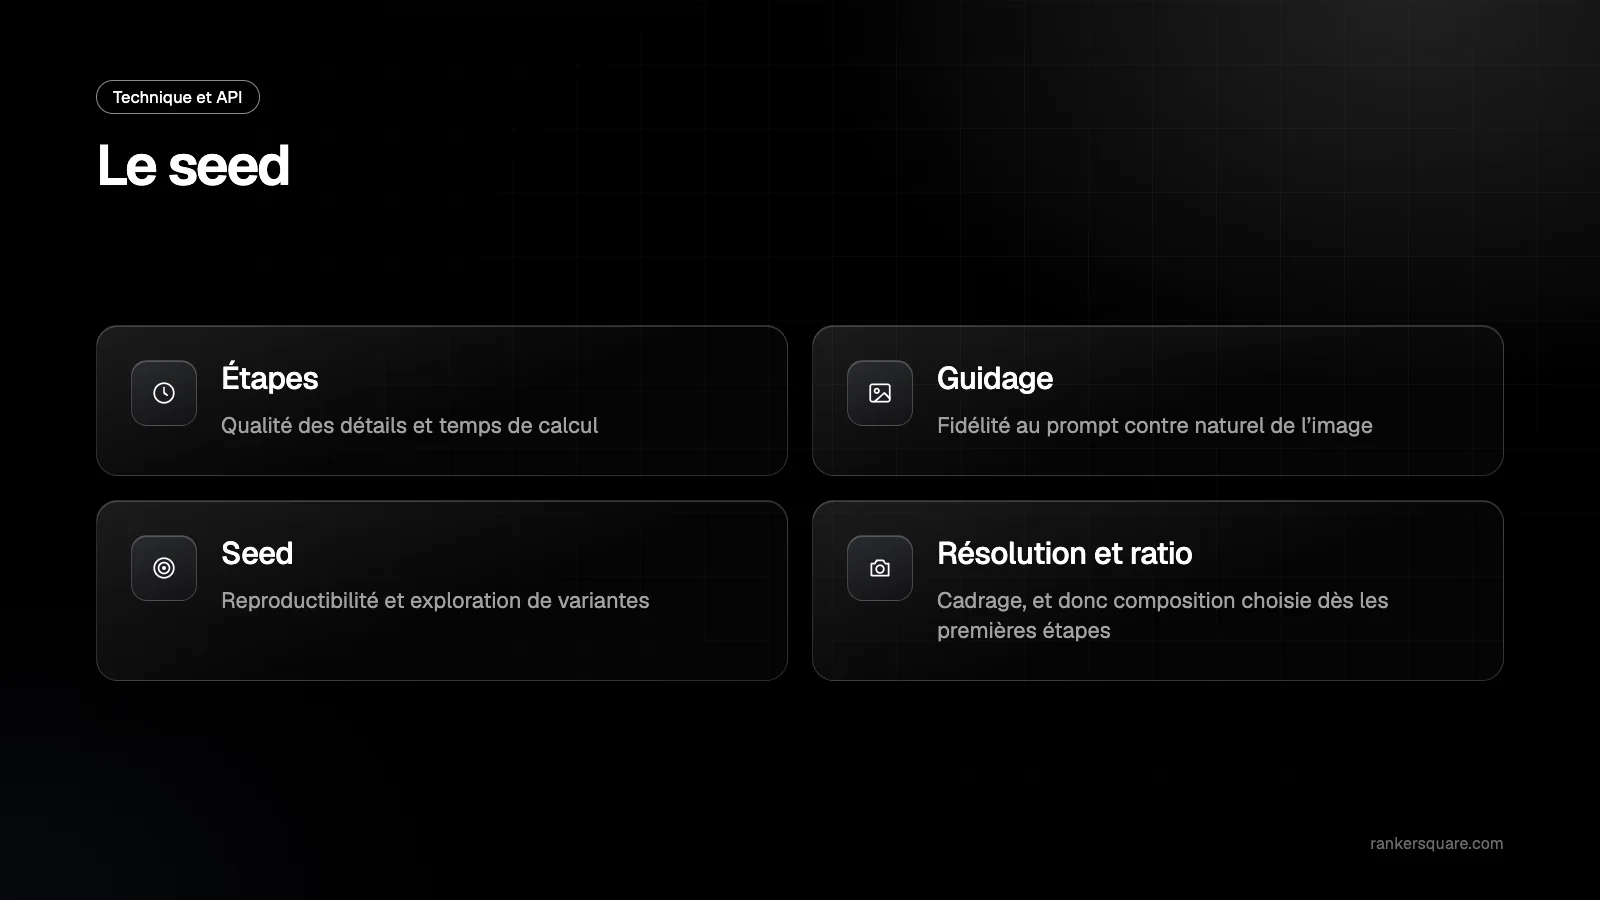
Le seed est le nombre qui détermine la grille de bruit de départ. Même prompt, même seed, mêmes réglages : vous retombez sur la même image. Changez le seed, et vous explorez une autre région de la distribution. C’est l’outil de travail le plus sous-estimé, comme nous l’expliquons dans notre article sur la différence entre seed et prompt.
- Étapes : qualité des détails et temps de calcul.
- Guidage : fidélité au prompt contre naturel de l’image.
- Seed : reproductibilité et exploration de variantes.
- Résolution et ratio : cadrage, et donc composition choisie dès les premières étapes.
- Image de départ, quand vous partez d’un visuel existant plutôt que d’un bruit pur.
Comment guider la diffusion inverse, étape par étape

Puisque le modèle décide de la composition dans les premières étapes et des détails dans les dernières, l’ordre dans lequel vous écrivez et corrigez compte vraiment. Voici la méthode que nous suivons en atelier, du cadrage vers la finition.
- Décrivez d’abord le sujet et le cadrage en une phrase claire : c’est ce qui se joue tout au début du processus inverse.
- Ajoutez ensuite la lumière et le rendu : type de source, direction, douceur, puis matière et focale.
- Lancez quatre générations avec des seeds différents et un guidage moyen, sans toucher au reste.
- Choisissez le seed le plus prometteur et verrouillez-le, puis ne modifiez qu’un seul élément du prompt à la fois.
- Écartez ce que vous ne voulez pas avec un prompt négatif, quand le modèle le prend en charge.
- Finissez par la retouche locale : reprendre une zone vaut mieux que relancer toute l’image.
Cette discipline du « un changement à la fois » est fastidieuse, et c’est exactement ce qui la rend efficace. Si vous modifiez le prompt, le guidage et le seed en même temps, vous ne saurez jamais lequel a produit l’amélioration. Les erreurs de prompt les plus fréquentes viennent presque toutes de là : des demandes empilées sans méthode, que le modèle moyenne au lieu de hiérarchiser.
Quelles applications concrètes pour vos images et vos vidéos ?
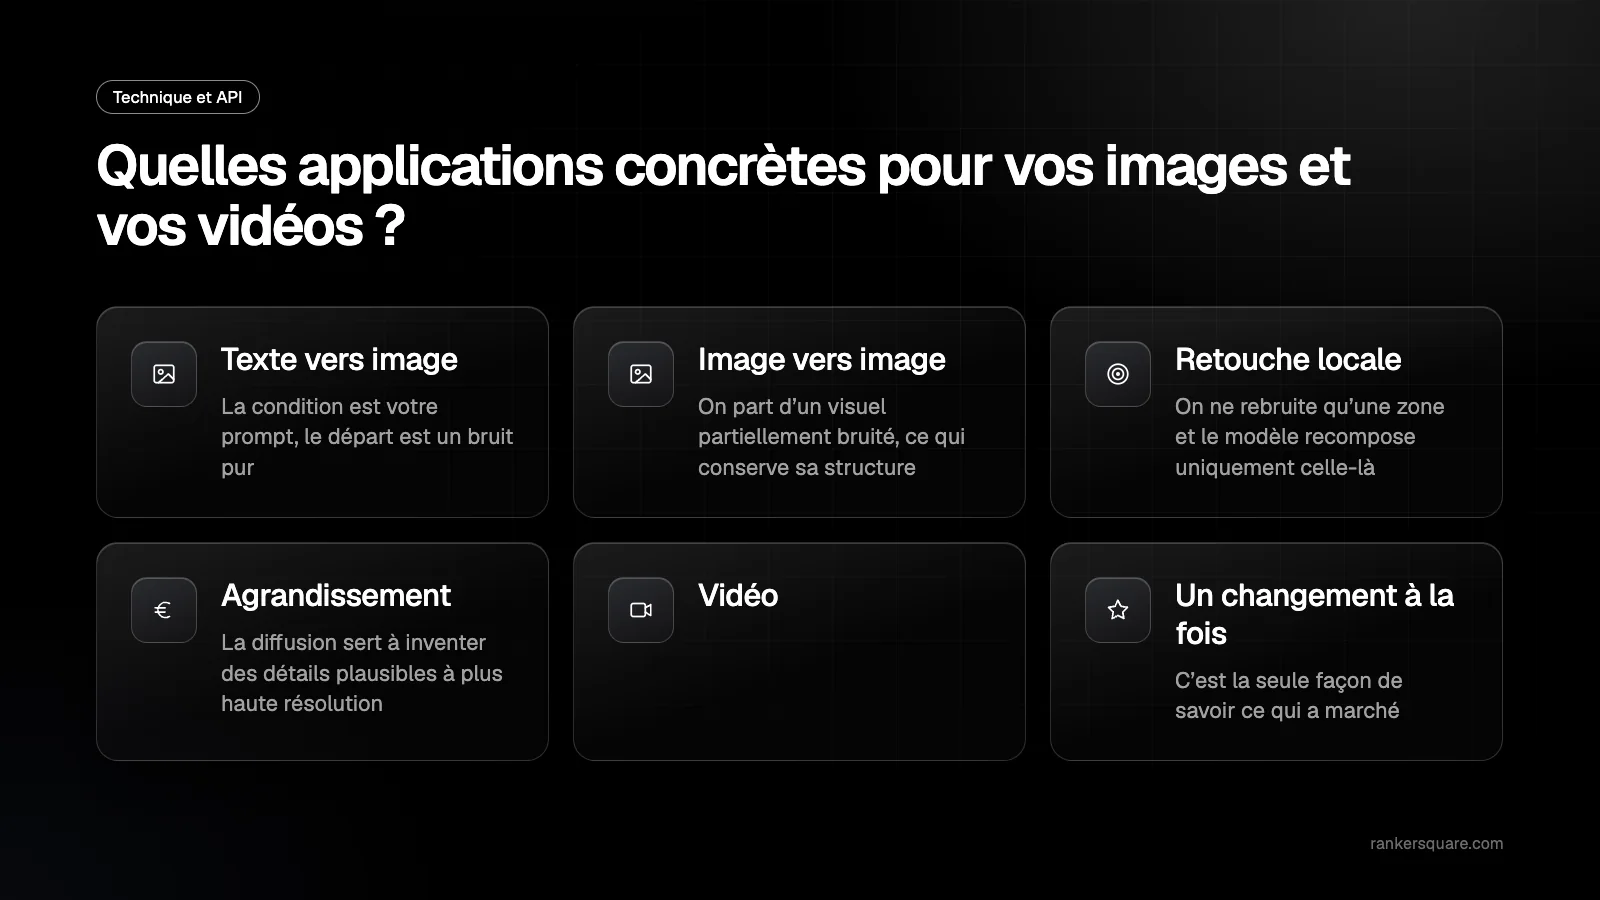
Le même principe sert bien au-delà du texte vers image. Dès qu’on sait débruiter en suivant une condition, il suffit de changer la condition pour obtenir un autre outil. C’est pourquoi autant de fonctions en apparence très différentes reposent sur la même architecture.
- Texte vers image : la condition est votre prompt, le départ est un bruit pur.
- Image vers image : on part d’un visuel partiellement bruité, ce qui conserve sa structure.
- Retouche locale : on ne rebruite qu’une zone et le modèle recompose uniquement celle-là.
- Agrandissement : la diffusion sert à inventer des détails plausibles à plus haute résolution.
- Vidéo : le bruit est traité sur plusieurs images liées, ce qui ajoute la cohérence temporelle, comme l’explique notre article sur le text to video.
Dans notre générateur d’images, ces variantes sont présentées comme des modules distincts, mais le moteur est le même. Côté coût, une image tourne autour de 2 crédits et une vidéo courte de 11 à 16 crédits selon le module : les étapes de débruitage, surtout en vidéo, sont ce qui pèse dans la facture. Réduire le nombre de générations à l’aveugle est donc la première économie à faire, bien avant de chercher un modèle moins cher.
Questions fréquentes
Un GAN fabrique l’image en une seule passe, en opposant un générateur et un discriminateur. Un modèle de diffusion y va par petites corrections, ce qui donne un entraînement plus stable et une meilleure couverture de la diversité des données. En échange, il demande plusieurs passages de calcul par image, donc plus de temps.
Dans le cas général, non : il a appris une distribution, pas une bibliothèque, et il ne stocke pas les fichiers. Des travaux ont toutefois montré qu’une image très dupliquée dans un corpus peut être partiellement restituée. Pour un usage professionnel, la prudence consiste à éviter de nommer un artiste vivant ou une marque, et à vérifier vos visuels avant publication.
Parce que le bruit de départ change à chaque fois. Si le seed n’est pas fixé, il est tiré au hasard, et le modèle part donc d’un autre point. Fixez le seed et vous retrouverez des résultats reproductibles, à réglages et modèle identiques.
Non, mais comprendre le sens des trois paramètres principaux fait gagner un temps considérable. Savoir que la composition se décide tôt et les détails tard vous dit quoi corriger, et quand. Le reste s’acquiert en comparant vos propres générations.




