ControlNet : c'est quoi et à quoi ça sert concrètement
ControlNet impose une pose, une profondeur ou des contours à votre image IA. Définition, modèles, réglages et erreurs à éviter, expliqués simplement.

ControlNet, c'est quoi exactement ?
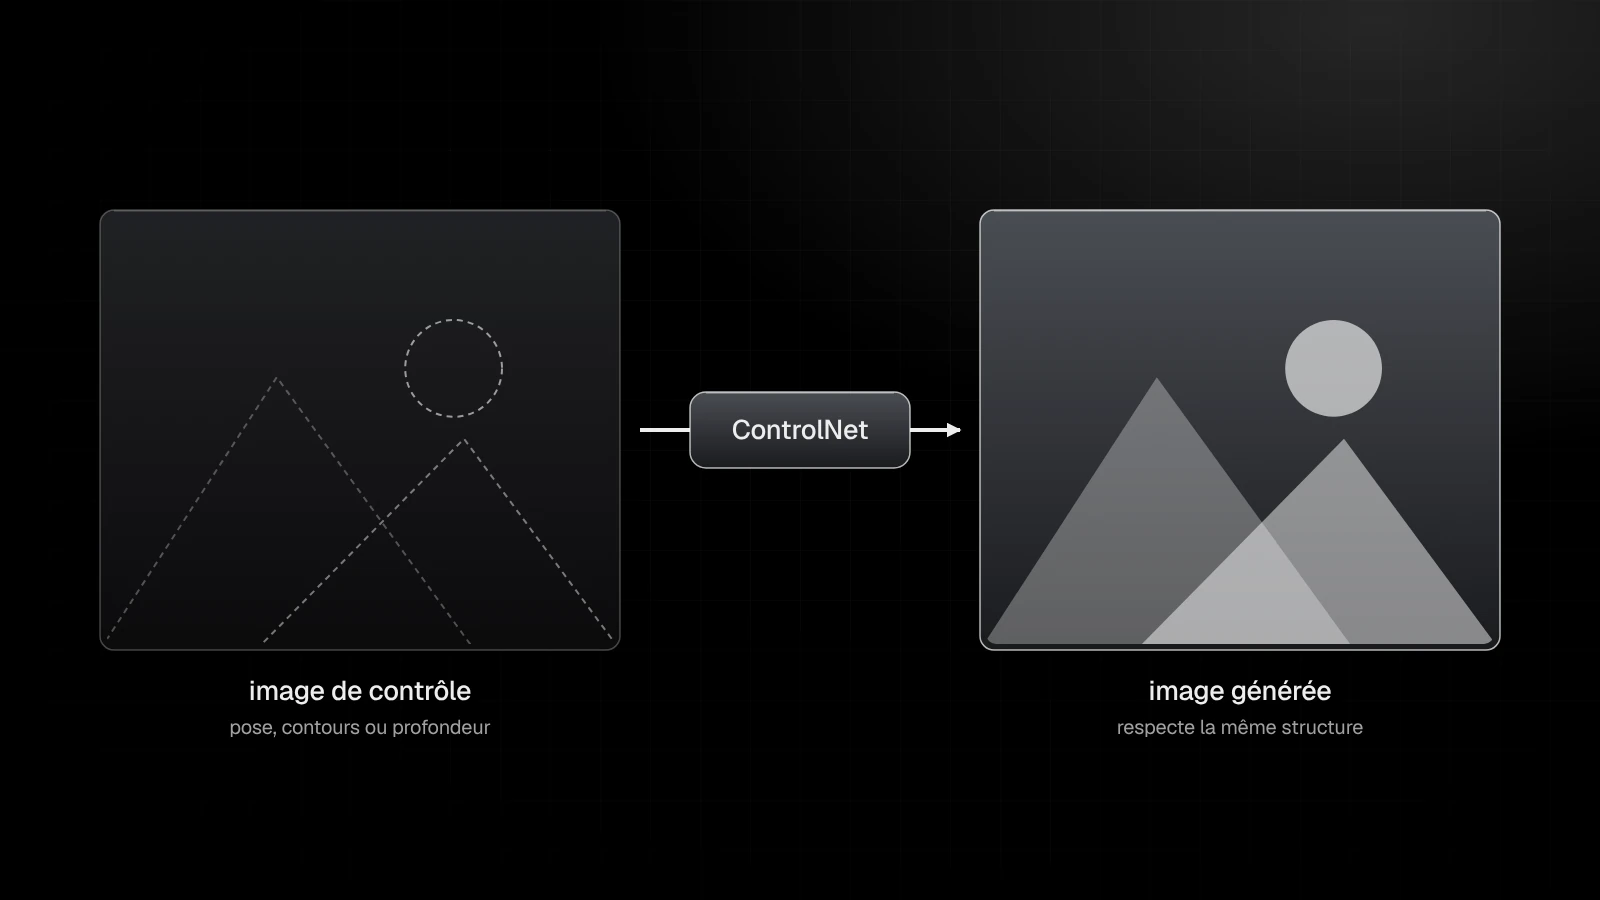
ControlNet est une architecture ajoutée à un modèle de diffusion, qui lui fournit une contrainte spatiale en plus du prompt. Vous donnez donc deux choses au modèle : votre texte, et une image de référence réduite à sa structure. Le texte dit quoi générer, ControlNet dit où le placer. La méthode est apparue en 2023 dans l'écosystème open source et s'est imposée vite, parce qu'elle règle un manque évident : le langage décrit mal la géométrie.
Un prompt comme « femme assise, jambes croisées, buste tourné vers la gauche » reste une approximation. Le modèle interprète, et il interprète différemment à chaque seed. Avec un contrôle de pose, cette information n'est plus une phrase mais un squelette dessiné que le modèle recopie. Nous sortons cet outil dès qu'un visuel doit respecter un gabarit imposé.
Un réseau parallèle, pas un nouveau modèle
Techniquement, ControlNet duplique une partie des couches du modèle de diffusion et entraîne cette copie sur un type d'information : contours, profondeur, segmentation. Le modèle d'origine reste gelé, intact. Le réseau ajouté réinjecte sa contrainte à chaque étape du débruitage. C'est toute la différence avec un LoRA, qui modifie un style ou un sujet appris, jamais la composition.
À quoi ça sert dans un vrai projet ?
Les applications sont très concrètes, et presque toujours les mêmes : garder un élément d'une image existante tout en refaisant le reste. Voici ce que nous en faisons le plus souvent.
- Reproduire une pose exacte depuis une photo de référence, pour un mannequin virtuel ou un personnage récurrent
- Transformer un dessin en visuel fini en gardant chaque trait, comme dans notre méthode pour passer d'un croquis à une image réaliste
- Conserver la perspective d'une pièce pendant qu'on change le mobilier, le style ou la lumière
- Garder la silhouette d'un packshot produit et refaire entièrement le décor autour
- Décliner une composition en plusieurs variantes sans que le cadrage bouge d'un pixel
- Ajouter du détail pendant un upscale, tuile par tuile, sans inventer d'objets absents
Comment ça marche, du croquis au rendu ?

Le processus se fait en deux temps. Un préprocesseur analyse d'abord votre image de référence et en extrait une carte : lignes de contour, carte de profondeur en niveaux de gris, squelette articulé. Le modèle ControlNet correspondant lit ensuite cette carte et guide la génération. Vous fixez un poids, en général entre 0,4 et 1, qui décide de la fermeté du guidage.
Ce réglage fait tout. À 1, la fidélité est maximale, mais le rendu devient rigide, avec des aplats étranges et des textures plates. À 0,5, le modèle garde la logique de la structure et s'autorise à respirer. Nous démarrons presque toujours à 0,7, puis nous ajustons selon le résultat. L'option pixel perfect, disponible dans la plupart des interfaces, aligne la résolution du préprocesseur sur celle de l'image et évite des contours baveux.
Quels types de ControlNet choisir ?

Chaque type lit une information différente, et le bon choix dépend de ce que vous voulez verrouiller. Les plus utilisés tiennent sur les doigts d'une main.
- openpose : le squelette, articulations et parfois mains et visage. Le réflexe pour les personnages.
- canny : les contours nets en noir et blanc. Très fidèle, parfois trop bavard sur les détails parasites.
- depth : la profondeur, du proche au lointain. Idéal pour garder un volume ou une perspective.
- lineart : les traits dessinés, pensé pour l'illustration et le line art propre.
- segmentation : des zones colorées par type d'objet, ciel, mur, meuble. Pratique pour composer un décor de toutes pièces.
- tile : découpe l'image et régénère chaque morceau, ce qui en fait un bon compagnon d'upscale.
On peut aussi les empiler. Un single ControlNet suffit dans la majorité des cas, mais un usage multiple se défend : openpose pour la pose, depth pour le volume, le prompt pour l'ambiance. Au-delà de trois contrôles, les contraintes se contredisent et le rendu se dégrade visiblement.
Où faire tourner ControlNet ?
L'outil vient de l'écosystème Stable Diffusion, donc il s'utilise surtout là. L'extension pour Automatic1111 reste la plus simple à prendre en main : une case à cocher, un menu déroulant, un curseur. ComfyUI demande de câbler les nœuds à la main et offre en échange un contrôle beaucoup plus fin sur un flux complexe. Les deux tournent en local et réclament une carte graphique correcte.
Il faut ensuite télécharger les bons fichiers, et c'est là que ça coince souvent. Un modèle entraîné pour SD 1.5 ne fonctionne pas avec SDXL, et les versions pour Flux couvrent aujourd'hui surtout canny et depth. Si vous ne voulez pas gérer d'installation, des plateformes exposent ce guidage directement en ligne : c'est l'approche que nous avons retenue, avec un générateur d'images et un module Motion Control qui appliquent la même idée sans dépendances à maintenir. Pour le socle technique, notre article sur Stable Diffusion sans installation fait le tour.
Quelles erreurs reviennent le plus souvent ?


La première est le poids trop haut. Avec un contrôle à 1 et une carte de contours sale, vous obtenez une image qui ressemble à un calque colorié au feutre. Descendez à 0,6 et le modèle reprend la main sur les matières.
La deuxième est le mauvais appariement : une carte de pose envoyée dans un modèle depth ne donne rien d'exploitable, juste du bruit structuré. La troisième vient du ratio. Si votre référence est en 3:4 et que vous générez en 16:9, la structure s'étire, les proportions partent. Recadrez avant, jamais après. Enfin, la structure est contrainte mais le style ne l'est pas : les erreurs de prompt se voient autant ici qu'ailleurs.
Questions fréquentes
Oui, mais avec des modèles dédiés à chaque famille. Ceux de SD 1.5 sont incompatibles avec SDXL, et l'offre pour Flux est encore inégale selon le type de contrôle. Vérifiez toujours la version annoncée sur la fiche du fichier avant de le télécharger, sinon l'interface le charge et ne produit rien de cohérent.
L'image to image repart des pixels de votre image et les transforme selon un taux de bruit. ControlNet ne retient que la structure extraite, sans les couleurs ni les textures. Vous pouvez donc changer complètement l'ambiance en gardant la géométrie, ce que l'image to image fait mal : à taux élevé, elle perd la composition.
Chaque contrôle ajoute de la charge en mémoire vidéo, en plus du modèle lui-même. Si vous générez déjà confortablement en local, un seul contrôle passe sans histoire. Deux ou trois en parallèle sur une carte modeste provoquent en revanche des saturations mémoire, et c'est le moment où une solution en ligne devient plus simple.
Le principe se retrouve en vidéo sous d'autres noms. Les modèles ouverts récents, dont la famille Wan 2.2, acceptent des conditionnements de pose ou de profondeur image par image, et les outils de transfert de mouvement reposent sur la même logique. La contrainte n'est plus seulement spatiale, elle devient temporelle : la structure doit rester stable d'une frame à l'autre, sinon le personnage tremble.




